
随着Deepfake技术不断进化,换脸、伪造语音、AI生成视频等恶意内容已成为网络安全领域的新型威胁。面对市面上层出不穷的深度伪造检测模型,如何客观评价其真实检测能力,如何从众多模型中筛选出高价值模型应用于实战防御,一直是行业亟待解决的难题。
针对这一痛点,合肥高维数据技术有限公司成功研发 “基于深度伪造视频检测的模型的评价方法及系统” ,并已获得国家发明专利授权(授权公告号:CN113326400B)。该专利通过建立公共视频样本库、引入参考模型校正机制、多维度加权评分,实现了对深度伪造检测模型的客观、稳定、可比较的自动化评价。
核心方案:用“参考模型”锚定评分基准
传统模型评价通常由研发者在有限样本集上测试得出,样本不同则评分差异大,难以横向比较。该专利创新性地引入参考模型校正机制:
系统内置一个或多个参考模型,并为其设定预设分值;
在同一批样本上,同时测试待评分模型与参考模型;
根据待评分模型与参考模型在各项指标上的表现差异,按正激励或负激励方向计算得分;
待评分模型表现优于参考模型则得分更高,劣于参考模型则得分更低。
这样一来,待评分模型的得分不再因样本集随机波动而大幅浮动,评分结果更稳定、更具参考价值。若设置多个参考模型,还可综合多个打分结果求取均值,使评价更合理。
多维度评价:速度、正确率、假阳率、假阴率
该专利支持对检测模型的多个关键指标进行评价:
检测速度:检测越快,得分越高;
检测正确率:识别越准,得分越高;
假阳率:误报越低,得分越高;
假阴率:漏报越低,得分越高。
各指标可独立评分,也可按权值加权平均得到综合得分。专利实施例中,检测正确率权重最高,检测速度、假阳率、假阴率权重较低,用户可根据实际需求灵活调整。系统最终可输出单项得分、综合得分及评分报告,方便模型间横向比较。
随机抽样:让评分更公正
视频样本库中样本数量庞大,如何抽样直接影响评分公正性。该专利设计了基于线性同余法的随机抽样流程:
从样本库中随机选取起始样本;
按预设递推方式生成新的随机序号;
舍弃重复序号,最终形成指定数量的不重复样本集。
通过该方式抽取的样本集随机性更强,可有效避免人为挑选偏差,让评分结果更具参考价值。
系统架构:样本库、智能评分、任务调度
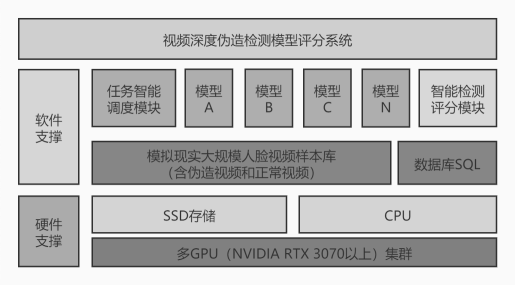
该评价系统由三大模块组成:
视频样本库:存储视频及其真伪标记,支持研究团队补充和更新;
任务智能调度模块:设置任务开始时间、样本集数量、每个样本集样本数量、并行任务数量,自动抽样并调度评分任务;
智能检测评分模块:预设评价指标,自动计算模型得分,输出评分报告。
待评分模型通过标准接口封装接入系统,支持功能测试、模型更新与下架。系统硬件部分由带GPU运算能力的服务器集群组成,具备存储和算力扩展性。所有评分任务结束后,系统通过加权平均完成自动评分,并支持评分报告展现和导出。
应用场景:从模型筛选到防御体系构建
该专利技术可广泛应用于以下场景:
深度伪造检测模型评测:为科研机构、企业提供第三方客观评分,筛选高价值模型纳入实战防御系统。
网络安全防御体系构建:通过持续评测,打造和巩固深度伪造检测防线,服务国家安全需求。
AI模型竞赛与认证:为深度伪造检测挑战赛提供标准化评分工具,推动技术良性竞争。
司法取证与鉴定:为司法机构评估伪造视频检测工具提供量化参考,辅助证据认定。
样本库生态共建:吸引模型研发人员参与样本库完善,形成“评测—反馈—优化”的良性循环。
平台内容治理:为短视频、直播平台提供检测模型选型依据,提升Deepfake内容拦截能力。
总体来看,该专利以“参考模型锚定、多维度加权、随机抽样”为核心,填补了深度伪造检测模型客观评价体系的空白,为网络安全防线建设提供了重要技术支撑。
技术交流与合作洽谈:请致电 0551-67122296
关注我们:获取更多【专利解读】与技术干货
分享本文:让更多面临同样安全挑战的伙伴看到它!
- END -
